01 / INPUT入力画像
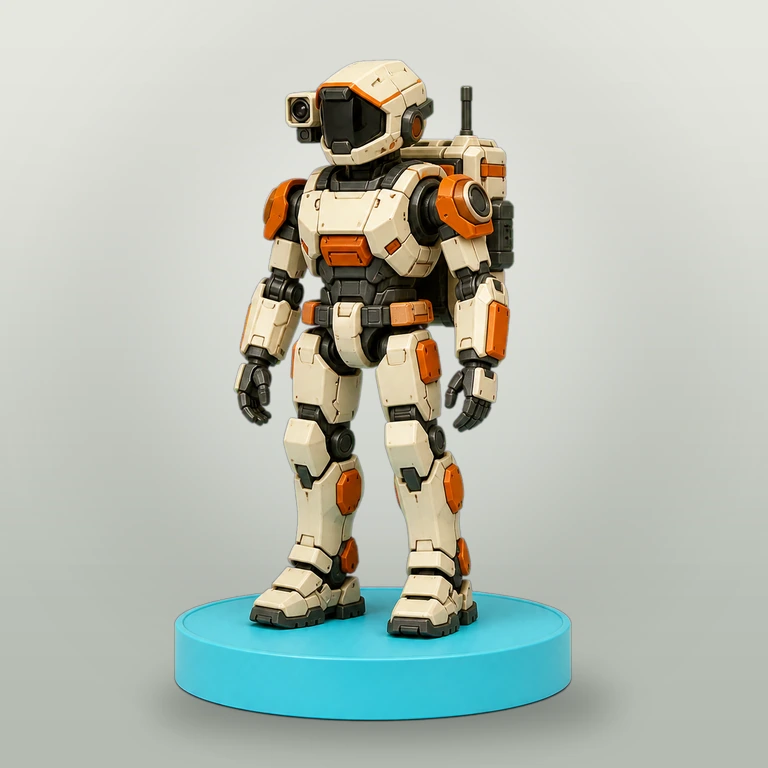
Original survey-robot figure
EXPLANATORY INPUT · 768 × 768 Diffusion Logic
VISUAL AI FOR BUSINESS SOFTWARE · TOKYO
Diffusion Logicは、SIer、受託開発会社、業界向けSaaS事業者、企業のDX担当者が取り組む画像認識案件を高速化します。画像から、個数・面積・位置・状態・判定などを算出し、業務で使える画面やデータへ変換します。
中核は、追加学習前でも自然言語で指定した多様な対象を高い品質で認識できる独自モデル基盤です。まず現在のモデルで試し、不足する部分だけを顧客データへ適応。MVPアプリまたはAPIとして既存ソフトウェアへ組み込みます。
PROTOTYPE / EARLY ACCESS
00 / VALIDATE BEFORE TRAINING
業務内容と非機密サンプルから、独自モデルが追加学習なしでどこまで対応できるかを確認します。十分ならそのままMVPやAPIへ。不足がある場合だけ、必要なデータを追加して顧客固有の判断基準へ適応します。
対象、除外条件、必要な数値や判定、利用先を共有します。
非機密サンプルで、現在のモデルがどこまで対応できるかを試します。
必要な場合だけ、選好や追加データで顧客固有の基準へ合わせます。
画面、CSV、JSON、Excel、APIなど、用途に応じた形で提供します。
追加学習に必要な画像数は、対象、撮影条件、正解基準、初期性能によって変わります。10〜50枚で適応可能性を確認できる場合もありますが、未知の対象や高い品質要件では、より多くのデータが必要になります。
EXAMPLE / PREFERENCE ADAPTATION
同じ画像でも、「フィギュアと台座を一体として扱う」「商品本体だけを扱う」のどちらも技術的には自然です。顧客が案件固有の正解を選び、その判断基準をモデルへ伝える流れを可視化しています。
Original survey-robot figure
EXPLANATORY INPUT · 768 × 768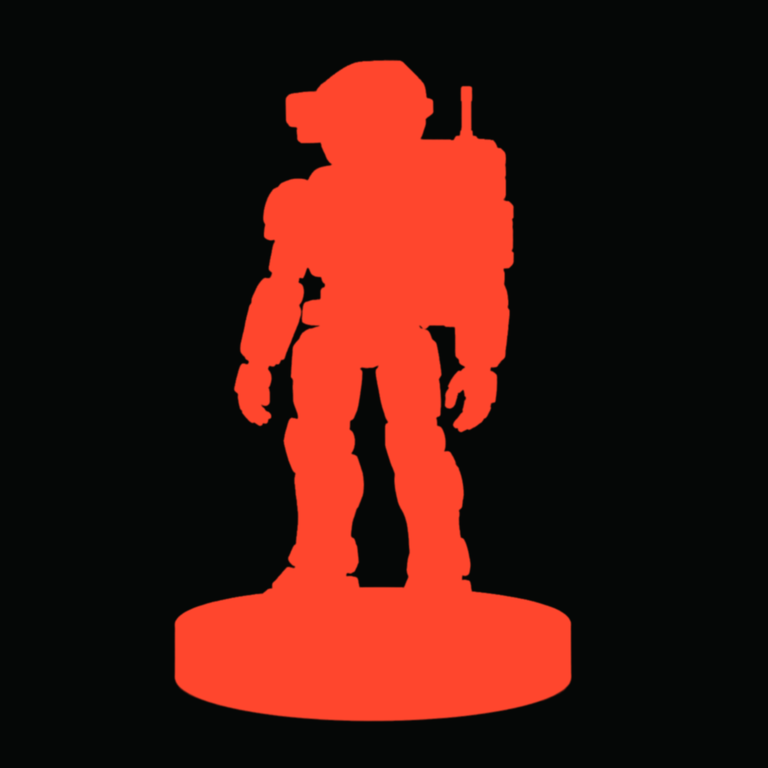
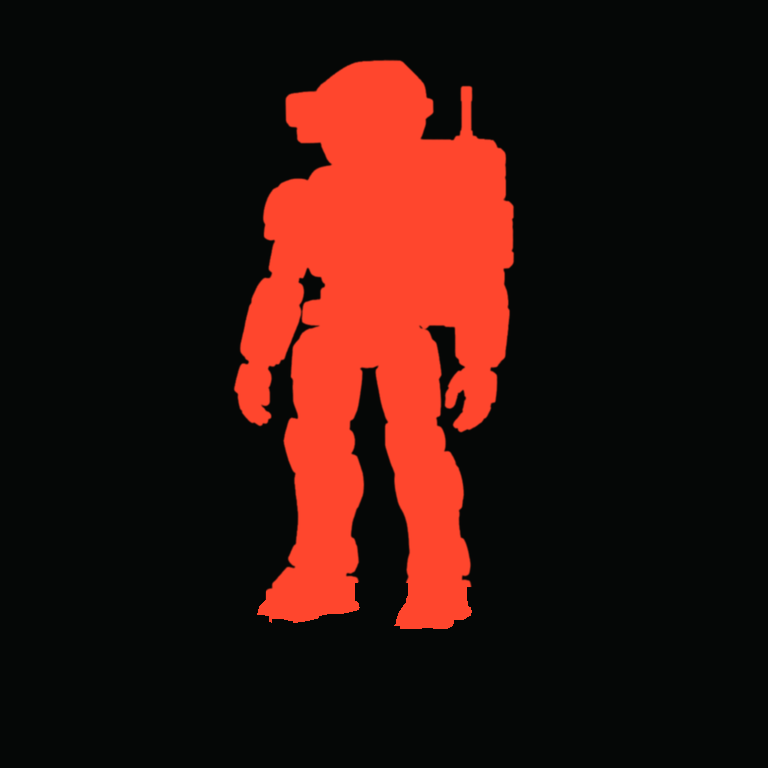
この選択は境界の失敗を直す指示ではなく、「何を対象と呼ぶか」を学習させるフィードバックです。複数の選好を通じ、新しい入力でも同じ定義へ一般化させます。
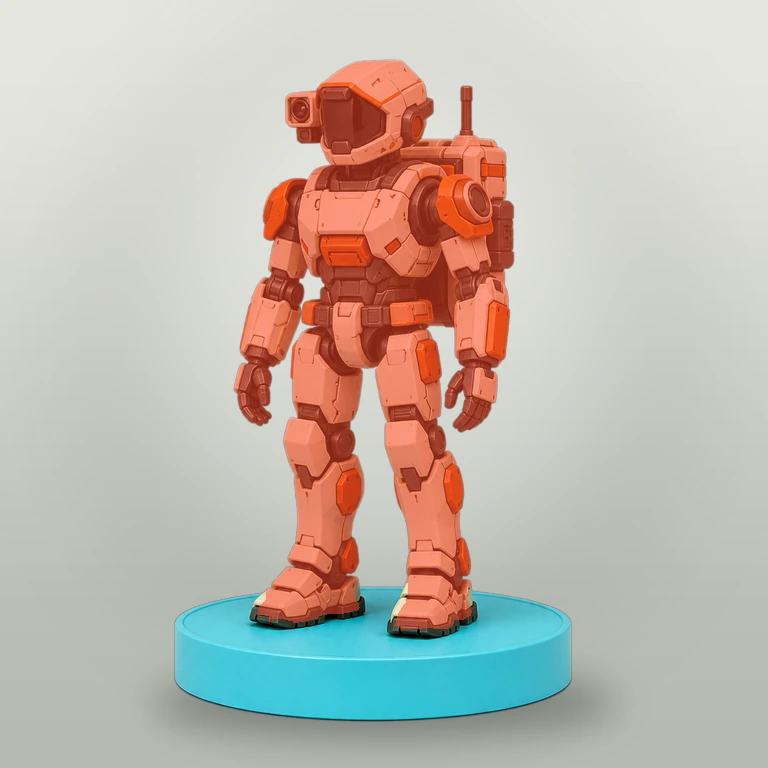
RGB画像はモデルの主出力ではありません。マスクを入力画像に重ね、台座が対象に含まれていないことを確認するための表示です。
ORIGINAL EXPLANATORY ASSETGenerated original figurine · pixel-aligned masks · 768 × 768
画像とマスクは、この判断構造を説明するために制作した権利上独立したオリジナルサンプルです。Y1/Y2は同一入力に対する2つの妥当な対象定義を示す図解であり、実案件の性能値や、1回の選択だけで適応が完了することを示すものではありません。
01 / PRODUCT
顧客や用途が変わっても、同じ独自モデルから始める。追加学習前の初期能力を起点に、画像AI部分を毎回作り直す負担を減らします。
Diffusion Logic独自モデルは、自然言語で指定した多様な対象を追加学習前から認識できます。まず同じ基盤モデルで試し、不足する部分がある場合だけ、少量のデータで顧客固有の対象や判断基準へ適応します。
TRADITIONAL / PER PROJECT
顧客が変わるたびに、画像AI部分を作り直す。DIFFUSION LOGIC / EARLY ACCESS FLOW
追加学習前の独自モデルから、案件を始める。* Early Accessでの検証フローです。初期性能、追加学習の要否、期間、必要画像数は、対象・画質・撮影条件・正解基準によって変わり、成果や納期を一律に保証するものではありません。
02 / FROM VISION TO BUSINESS OUTPUT
非機密サンプルで、追加学習前の独自モデルが対象をどこまで認識できるか確認します。
初期結果で不足する部分だけ、選好や追加データから顧客固有の対象と判断基準へ適応します。
認識結果を個数・面積・位置・状態・判定へ変換し、確認画面を備えたMVPアプリを生成します。
APIとして既存ソフトウェアへ組み込み、追加画像や新しい対象への評価と改善を管理します。
03 / FIND A VISUAL AI PROJECT
画像認識の技術名を知らなくても問題ありません。写真・映像・図面を見ながら行っている作業を教えてください。抽出すべき領域、必要な数値、人が確認する基準から、検証できる画像AIプロジェクトへ整理します。
既成の汎用モデルをそのまま当てるだけでは、細線・微小物・不定形な状態を業務上の正解として扱いにくいことがあります。共通の視覚基盤へ領域別の追加学習を行い、学習に使用していない固定評価画像を2-stepで推論しました。色の半透明領域が、モデルが実際に抽出した部分です。
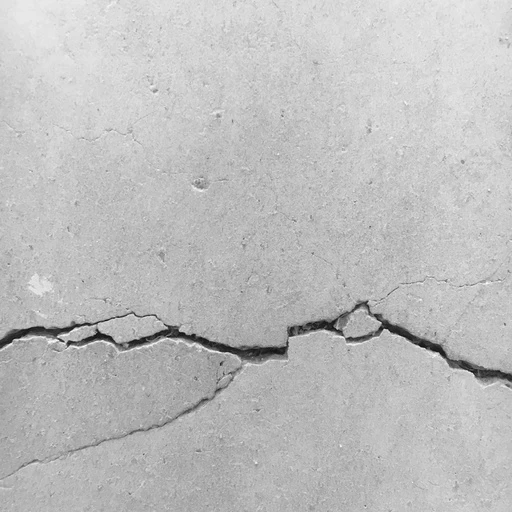
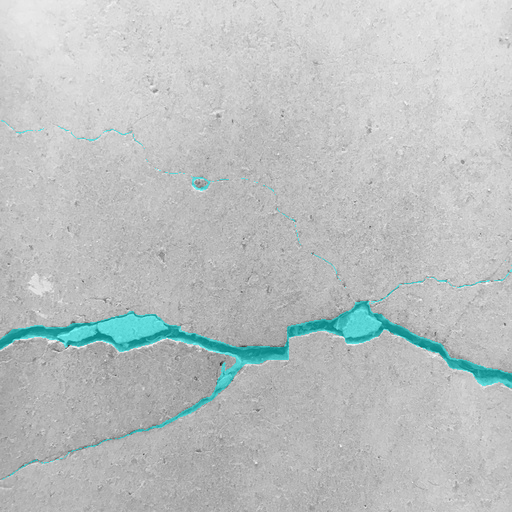
細い亀裂と太い破断部を同じマスクとして抽出。位置、画素面積、確認対象一覧へ変換できます。
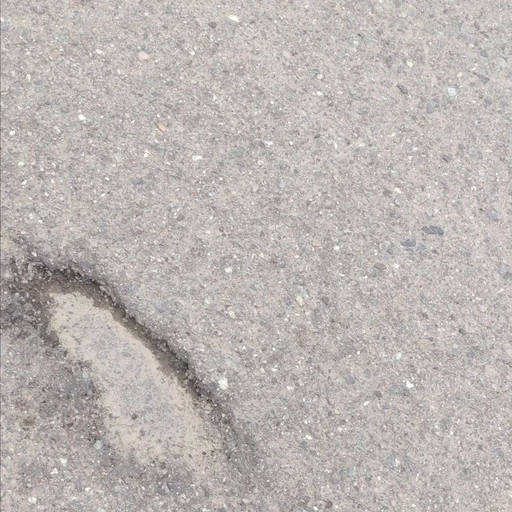
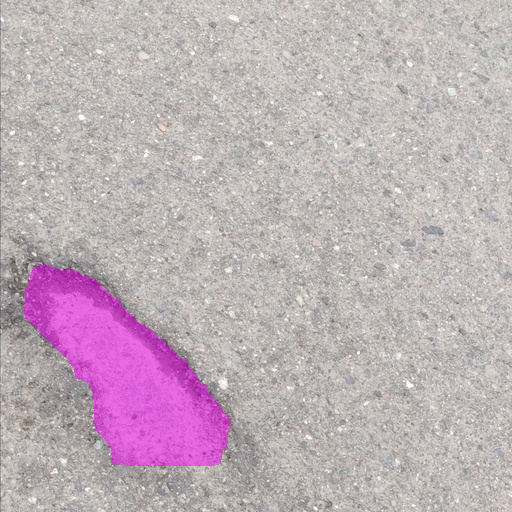
舗装の損傷領域を輪郭に沿って抽出。画像ごとの損傷率や補修候補の記録へつなげます。
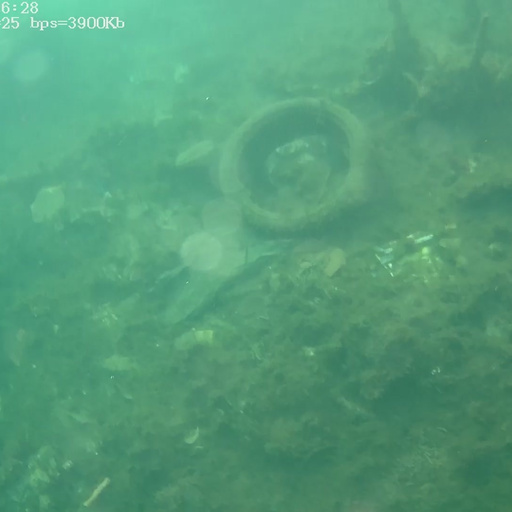
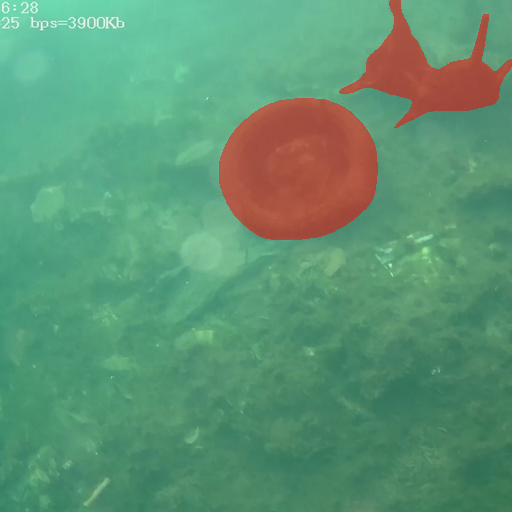
濁りや複雑な背景の中からごみ領域を抽出。港湾・海洋調査の確認候補、位置、画像内占有率へ変換できます。
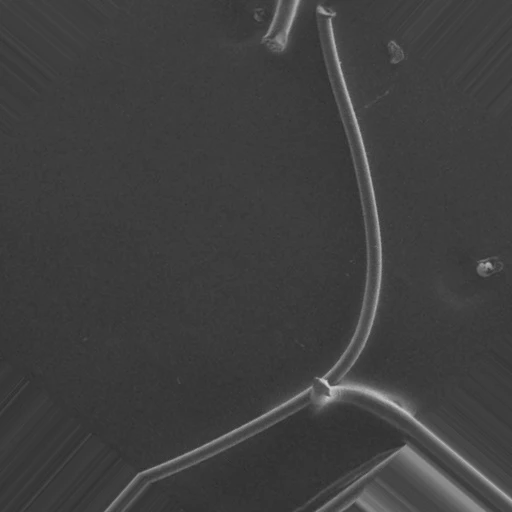
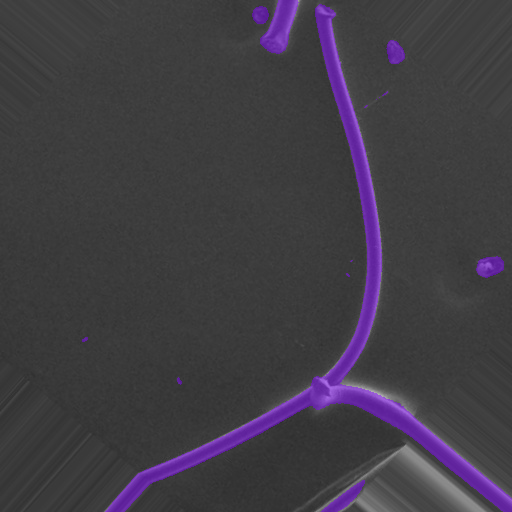
細い繊維と小さな粒子候補を領域化。候補位置、面積、個数集計の入力として返せます。
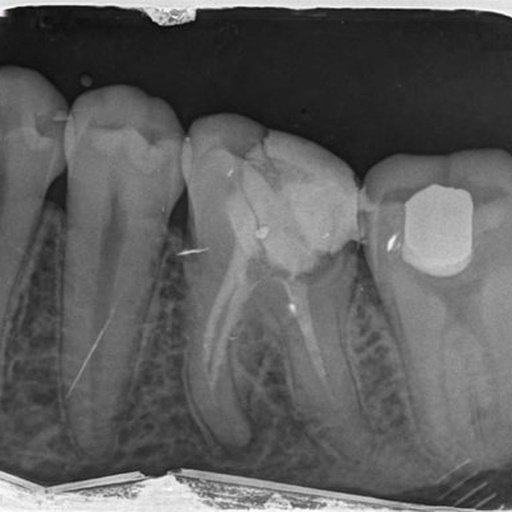
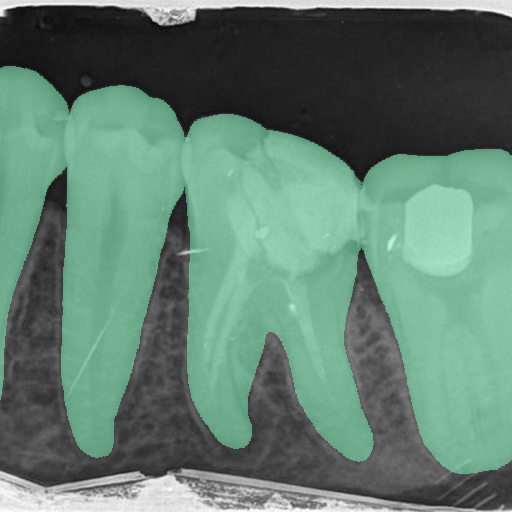
歯の輪郭と位置を領域化。研究・専門家支援向けの構造可視化、部位別の確認、計測補助の入力になります。
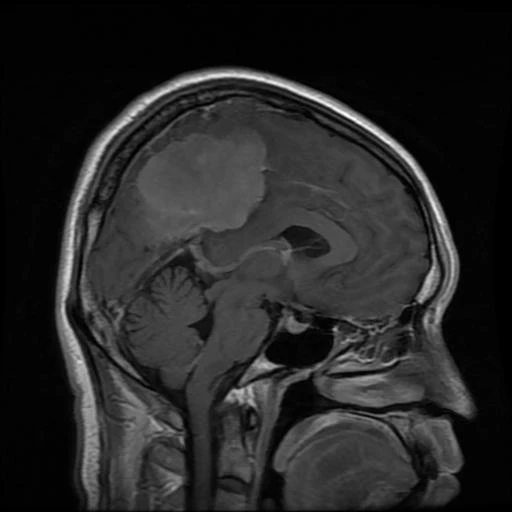
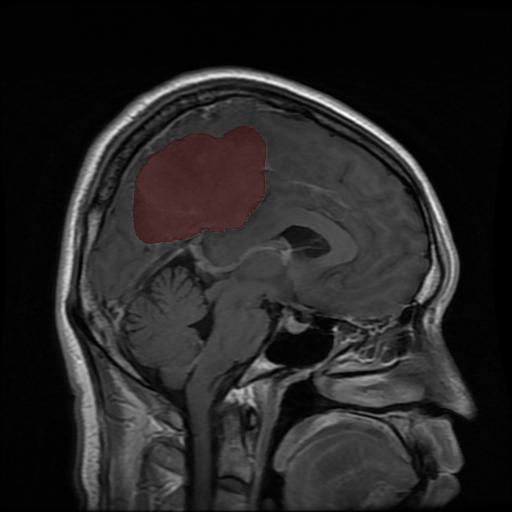
画像内の候補領域をマスク化。確認用オーバーレイや面積推移など、専門家支援の入力へ変換できます。
WHAT THE NUMBER MEANS Dice / IoUは、モデル出力と正解マスクの重なりを測った値です。1.0に近いほど一致しています。
* 推論時間はモデル読込後の同一GPU上での実測です。各数値は固定評価画像1枚の結果で、案件全体の精度を保証するものではありません。医療例は研究評価であり、診断性能を示すものではありません。
画像を押して展開 元画像とAIの初期判定を見比べながら、具体的なプロジェクト例を4件ずつ確認できます。
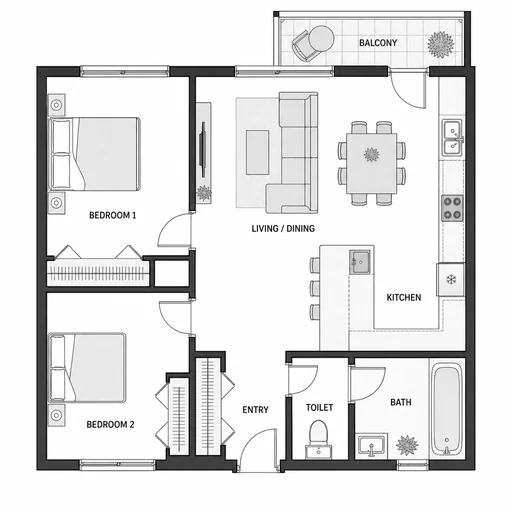
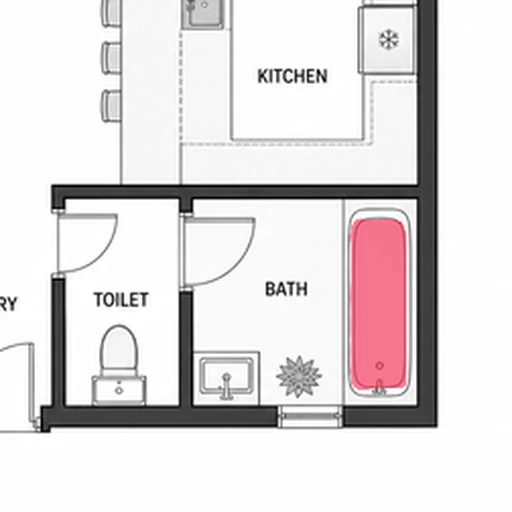
平面図から指定した設備を領域として取り出し、個数と位置を後工程へ渡します。
右は、同じ平面図から浴槽を実際に1か所抽出したモデル出力です。設備名や図面形式が変わる場合も、まず現在のモデルで試し、不足する部分がある場合だけ追加データで適応します。
部屋・壁・設備記号を抽出し、面積・位置・数量をExcelや積算データへ。
定点写真から施工済み領域を抽出し、前回撮影との差分を記録。
ひび・剥離・錆の位置と広がりを抽出し、点検記録を省力化。
パネルの枚数・配置・異常候補を画像から整理し、現地調査を支援。
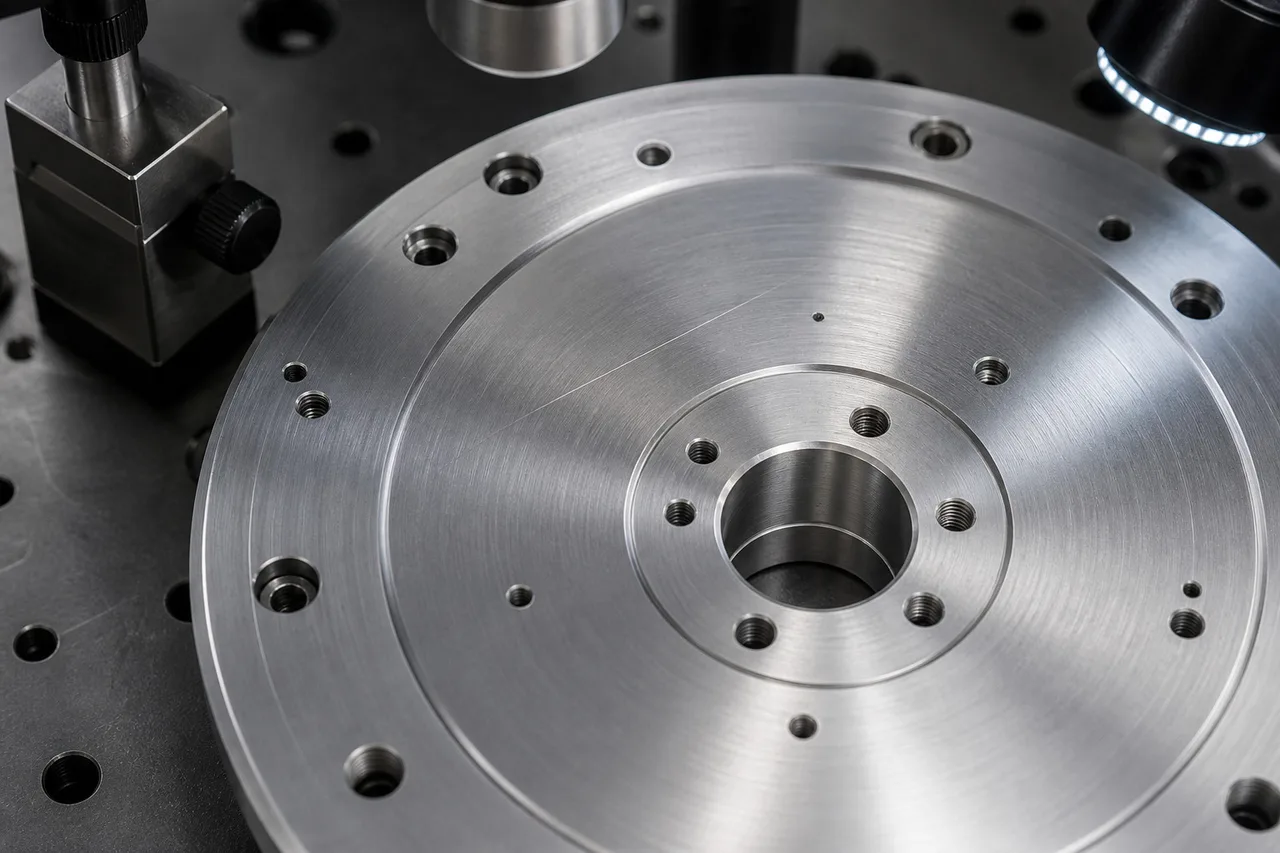
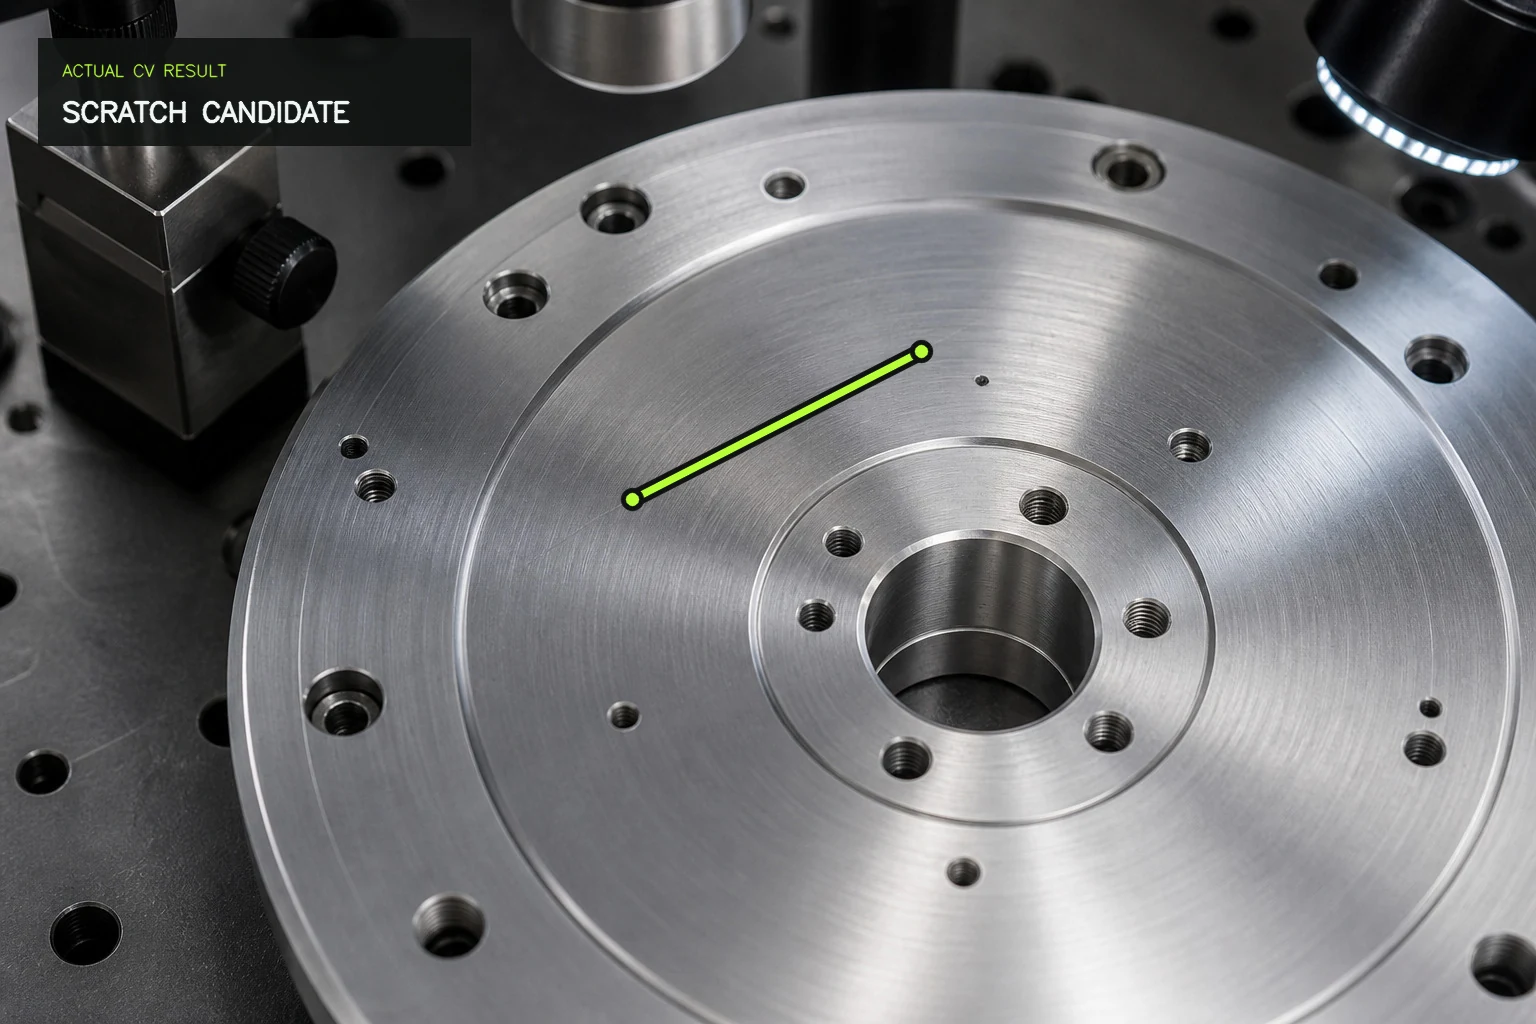
製品表面の傷・欠け・汚れなどを画像から抽出し、検査担当者へ位置と数値を返します。
右は、同じ画像に実際に見えている長い斜め傷候補1本を検出した結果です。画像上の長さは325px、角度は約27°です。mm換算や合否判定には、撮影条件と検査基準が必要です。
傷・欠け・汚れ・異物の場所を抽出し、検品担当者の確認を支援。
指定部品やコネクタが正しい位置に付いているかをカメラで確認。
巡回写真から変化箇所を見つけ、優先して確認すべき設備を整理。
返却時の写真から部品欠損や損傷候補を記録し、点検を標準化。
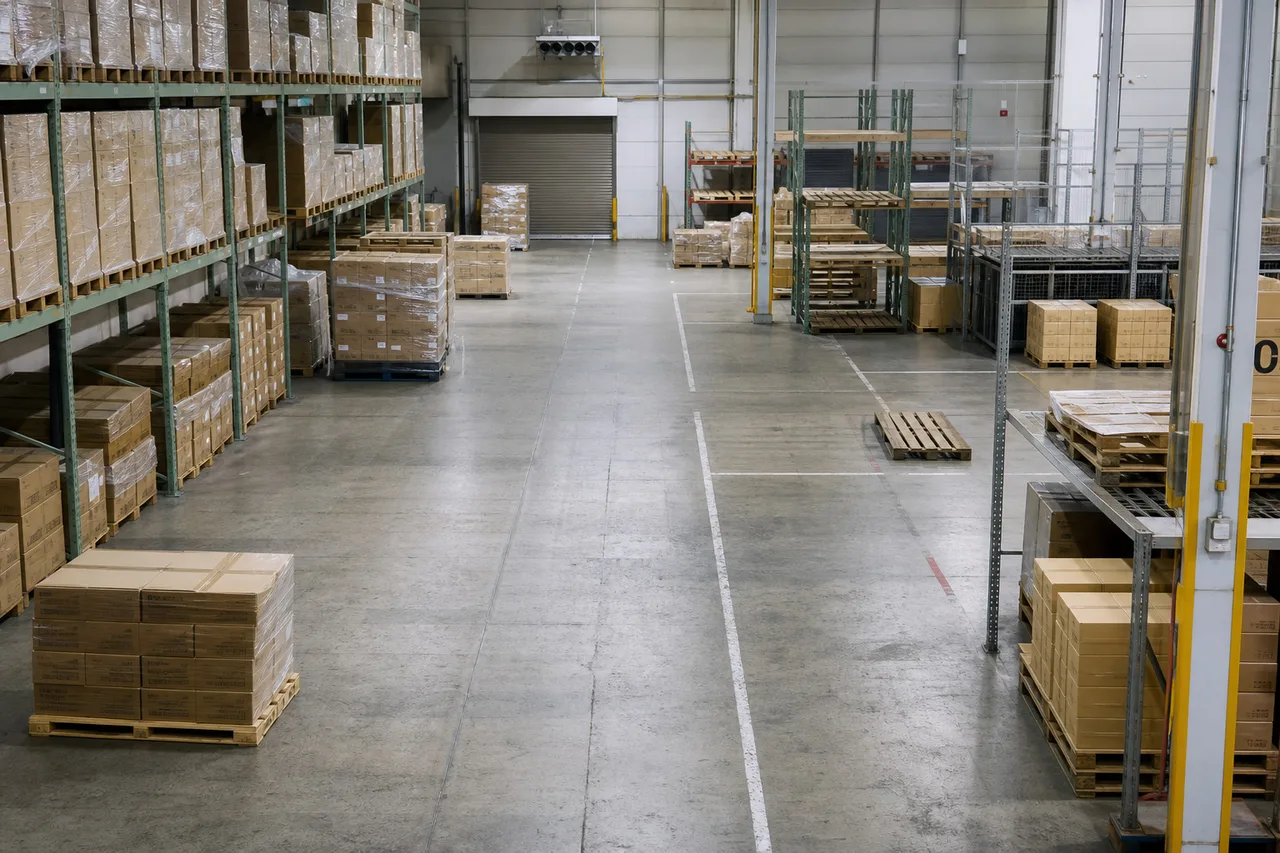
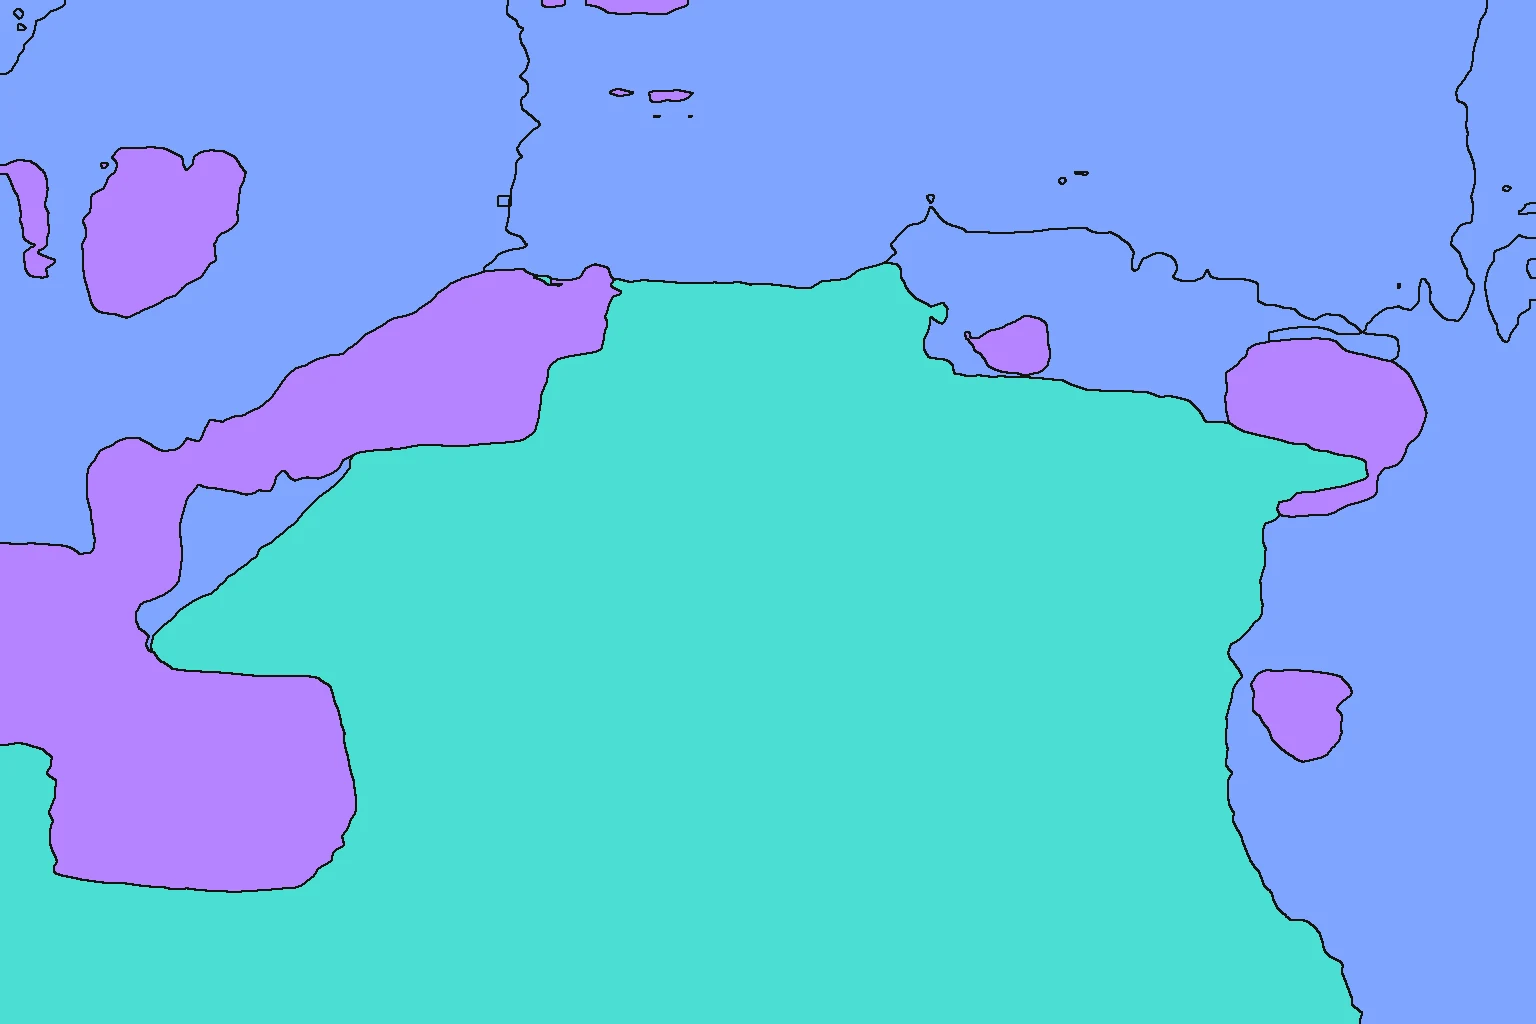
倉庫画像を画素単位で分け、床・棚・箱などが画像内のどこにあるかを取得します。
右は、同じ倉庫画像を実際に領域分割した初期結果です。今回の画像では床44.0%、棚26.5%、箱12.6%を占めています。
倉庫画像から荷物の位置と個数を取得し、確認作業を短縮。
棚や床の占有領域を抽出し、補充や保管場所の判断を支援。
商品と空き領域を認識し、店舗巡回時の確認項目を自動整理。
荷物の配置と空き領域を可視化し、積載効率や安全確認へ活用。
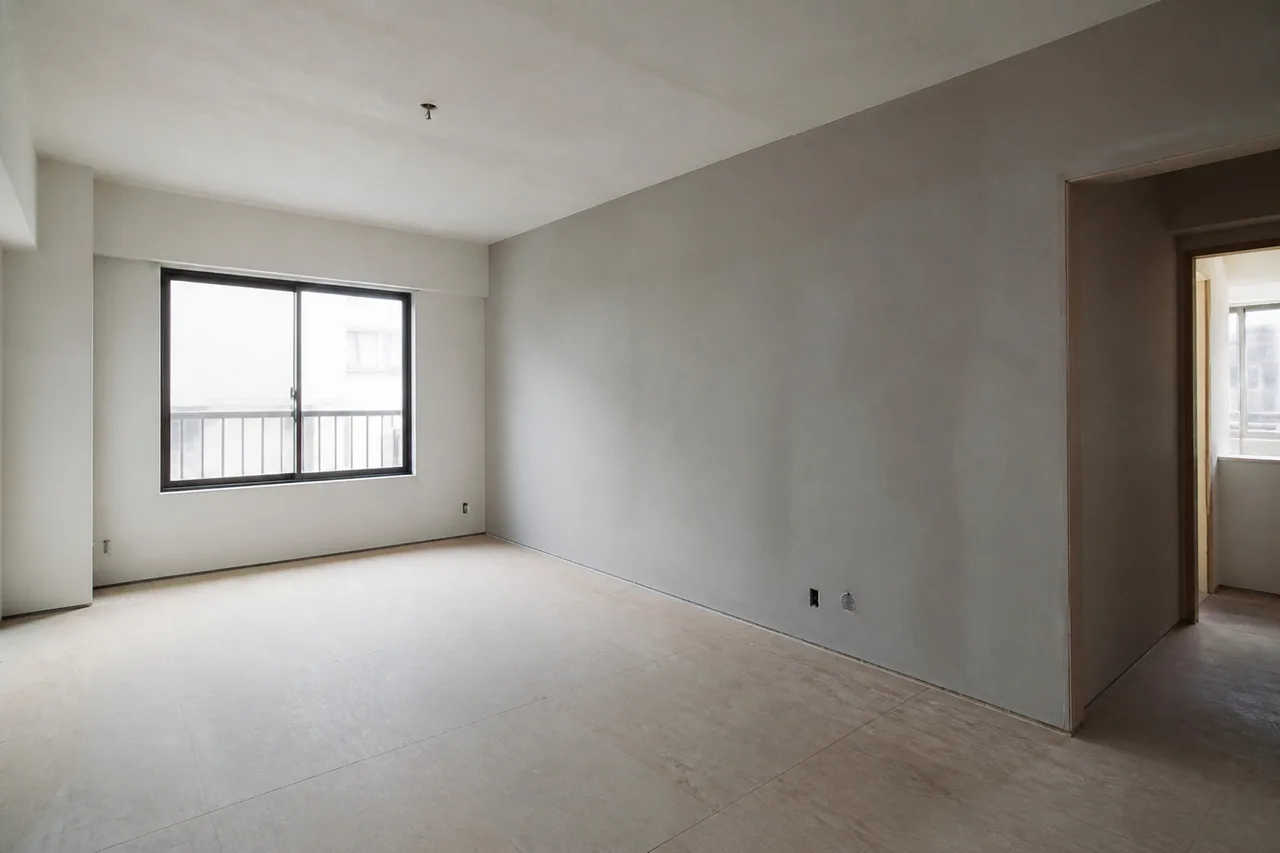
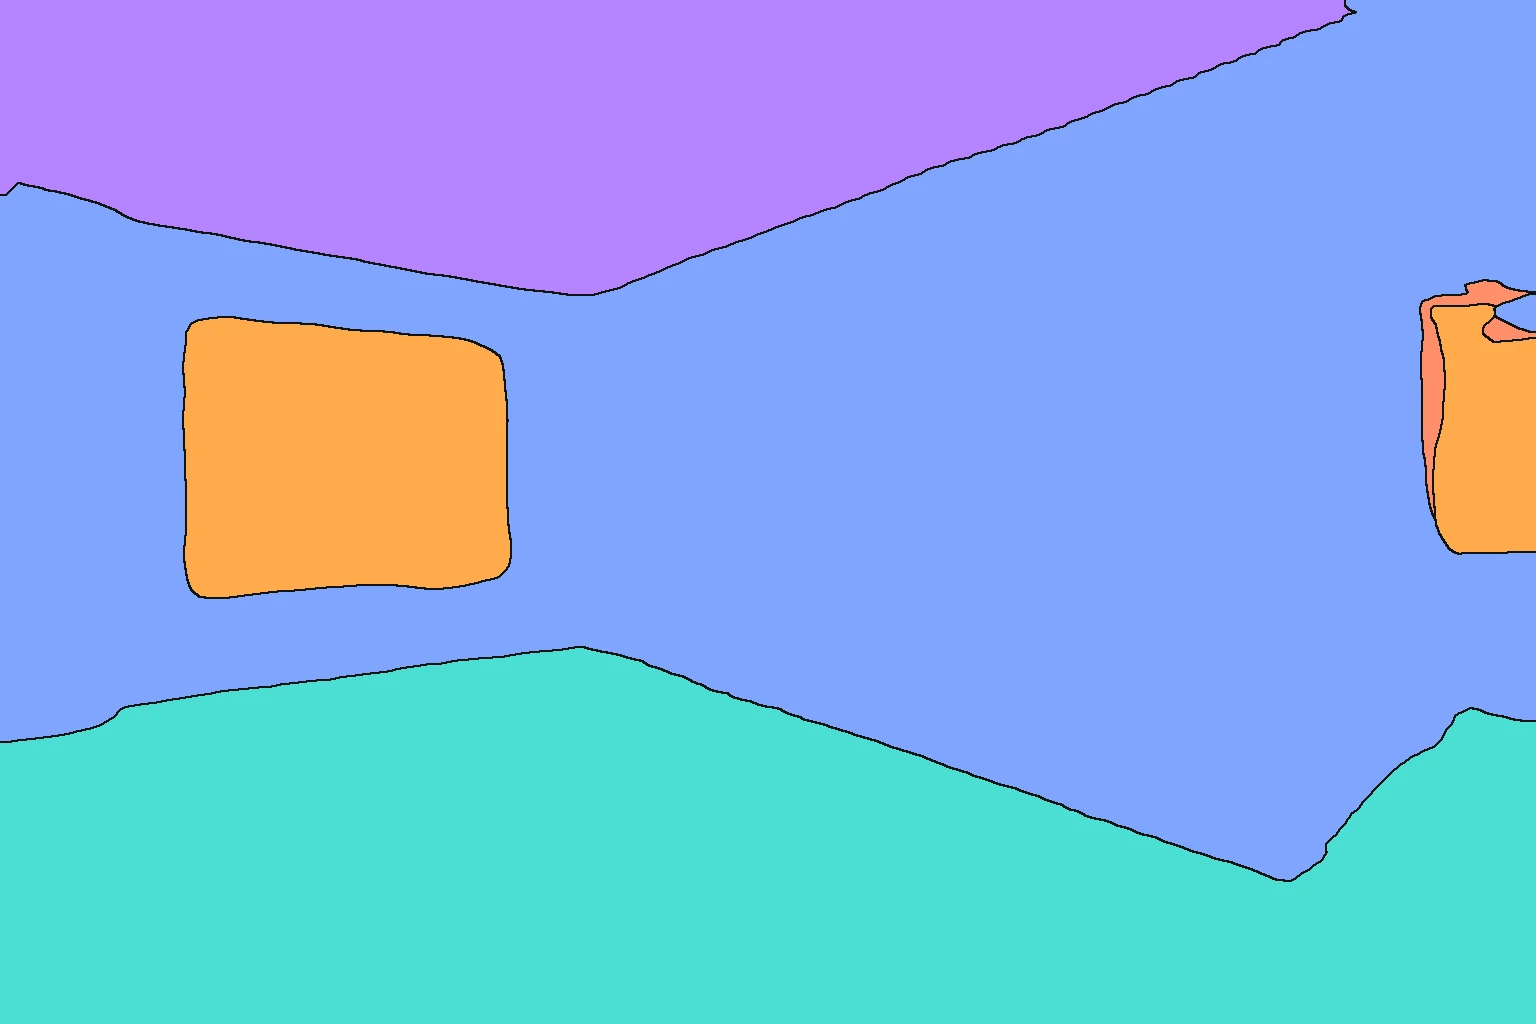
1枚の室内写真から、床・壁・窓が画像のどこにあるかを構造化データとして取得します。
右は、同じ室内画像を実際に領域分割した初期結果です。今回の画像では壁47.9%、床28.2%、窓6.7%を占めています。案件固有の部材・採寸・合否には追加の学習と評価が必要です。
床・壁・開口部と奥行きを取得し、面積計算や改修見積の入力へ。
室内の床面と空間形状を捉え、配置候補やAR表示の前処理に活用。
商品だけを切り抜き、背景変更や生成処理に使える形状・奥行き情報を取得。
対象本体と傷・凹み候補の位置を整理し、人による査定を標準化。
各カードは、左に入力画像、右に同じ画像への実際のモデル推論・画像処理結果を表示しています。表の数値も、右に表示した結果から算出しています。いずれも顧客案件や導入実績ではなく、ローカル検証例です。
領域比率と画像上の長さは実際の出力値です。cm・mなどの実寸値へ変換するには、カメラ情報や画像内の基準寸法が必要です。案件固有の合否・数量・精度を保証するものではありません。
実現性・必要画像数・精度は、対象、撮影条件、正解基準、既存モデルの初期性能によって変わります。まず非機密サンプルで検証します。
04 / FOR SIERS, SAAS & DX TEAMS
Diffusion Logicは、SIer、受託開発会社、業界向けSaaS事業者、企業のDX担当者が、画像AI機能を自社の画面や業務システムへ組み込むための共通基盤を提供します。高い汎化性能を起点に、必要な部分だけを顧客ごとに適応します。
05 / ROADMAP
目指すのは静止画APIだけではありません。汎用性と推論速度を高め、将来のロボット・現場システムに組み込める視覚知覚基盤へ拡張します。
追加学習前の初期検証、セグメンテーション、図面理解、検査、必要に応じた少量データ適応。
動画、追跡、時間的一貫性。専用GPUとバッチ推論。
低遅延ストリーミング、Jetson、深度・姿勢・3D。
ロボットが直接利用できる、高速で汎用的な知覚API。
導入実績としての公開はまだありません。Early Accessおよび共同検証パートナーを募集しています。
FROM PROJECT IMAGES TO REAL-TIME ROBOTIC PERCEPTION
Diffusion explores possibility.
Logic makes it reusable.
生成モデルが持つ柔軟な視覚知識を、再現可能な適応・評価・APIへ。個別案件から学びながら、次の現場でも使える基盤へ育てます。
EARLY ACCESS / JOINT VALIDATION
SIer・受託開発会社・業界向けSaaS・企業のDX部門から、画像AI案件や共同検証のご相談を受け付けています。業務内容、「何を見分けたいか」、共有可能なサンプルをお知らせください。
非機密サンプルで適用可能性を確認 ↗ hello@diffusionlogic.com · 25分のオンライン相談から · contact@diffusionlogic.com でも受信できます